
 6th September 2023
Solución de problemas y solución de CrashLoopBackOff de Kubernetes
Kubernetes es la herramienta de orquestación de contenedores número uno. Pero como cualquier sistema complejo, Kubernetes encuentra escenarios de error como el frustrante CrashLoopBackOff.
En este tutorial, comprenderá las razones detrás del error CrashLoopBackOff. Equípese con estrategias efectivas de solución de problemas para identificar y solucionar las causas subyacentes de este terrible error.
¡Conquista los errores de CrashLoopBackOff y mantén tus implementaciones en buen estado!
Requisitos previos
Antes de sumergirse en las demostraciones prácticas, asegúrese de tener lo siguiente en su lugar:
- Un clúster de Kubernetes en ejecución.
Solucionar configuraciones erróneas que causan errores CrashLoopBackOff
Normalmente, cuando implementa un recurso en un clúster de Kubernetes, no conoce los procedimientos exactos ni el ciclo de vida de cómo se implementó un recurso. La buena noticia es que Kubernetes siempre registrará el estado y los pasos ejecutados para crear diferentes contenedoresEstados.
PodStatus deja rastros de los contenedores en el Pod que se inicializaron exitosamente, se ejecutaron, estuvieron en espera o terminaron. Estos estados registrados le permiten ejecutar rápidamente un comando que soluciona problemas de las condiciones de un Pod.
Para ver cómo solucionar un error CrashLoopBackOff en acción:
1. Crea un implementación.yml archivo con su editor preferido y agregue la configuración a continuación.
Lo siguiente está mal configurado intencionalmente con un comando defectuoso (command: ["sh", "-c"]) para replicar un error CrashLoopBackOff.
apiVersion: apps/v1
kind: Deployment
metadata:
  # Deployment name
  name: crashloop
spec:
  # Number of instances of the pod
  replicas: 1
  selector:
    matchLabels:
      # Selector matching Deployment pods
      app: crashloop
  template:
    metadata:
      labels:
        # Labeling pod template
        app: crashloop
    spec:
      containers:
        # Container name
        - name: crashloop-example
          # Docker image
          image: nginx:latest
          ports:
            # Container port
            - containerPort: 80
          # Faulty container command
          command: ["sh", "-c"]
2. A continuación, abra su terminal o PowerShell como administrador y ejecute lo siguiente kubectl dominio.
Este comando te permite apply sus configuraciones de implementación para crear un clúster de Kubernetes como se define en su deployment.yml archivo.
kubectl apply -f deployment.yml3. Después de la implementación, ejecute el kubectl get comando a continuación para ver (get) todo pods.
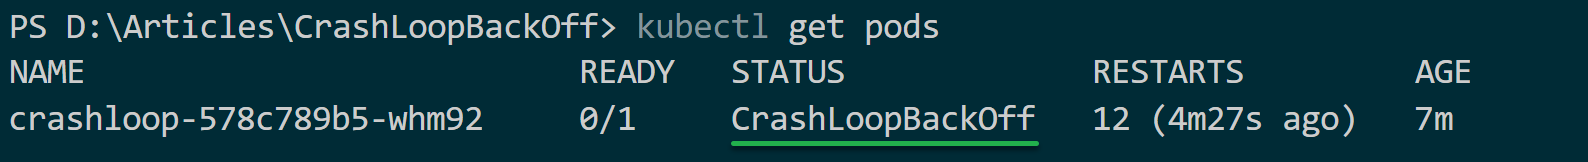
A continuación, su Pod actual muestra el CrashLoopBackOff estado y no está listo (0/1) para ejecutar su contenedor, y el kubelet restartPolicy reiniciaste tu Pod al menos una vez.
El estado CrashLoopBackOff mantiene constantemente los Pods en un ciclo de reinicio para estabilizar y ejecutar el contenedor con éxito. Si el intento de reinicio falla, el Objeto API PodStatus entra en un estado CrashLoopBackOff.
Anota el nombre de tu Pod para usarlo más adelante al investigar el error CrashLoopBackOff.
4. Ahora, reemplace la configuración en su implementación.yml archivo con el siguiente.
Dado que el comando del contenedor se corrigió, esta configuración activa un clúster de Kubernetes mínimo usando NGINX.
apiVersion: apps/v1
kind: Deployment
metadata:
  # Deployment name
  name: crashloop2
spec:
  # Number of instances of the pod
  replicas: 1
  selector:
    matchLabels:
      # Selector matching Deployment pods
      app: crashloop2
  template:
    metadata:
      labels:
        # Labeling pod template
        app: crashloop2
    spec:
      containers:
        # Container name
        - name: crashloop2-example
          # Docker image
          image: nginx:latest
          ports:
            # Container port
            - containerPort: 80
          # Container command - Fixed
          command: ["nginx", "-g", "daemon off;"]
5. Vuelva a ejecutar el siguiente comando de implementación para apply los cambios en tu deployment.yml archivo.
kubectl apply -f deployment.yml
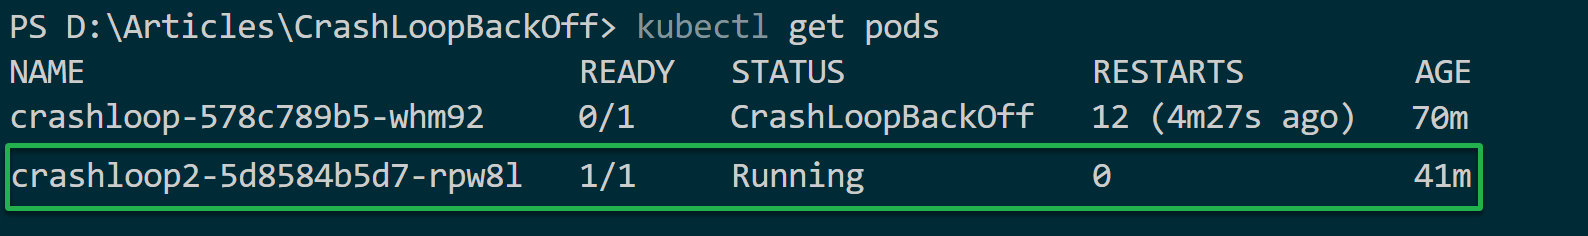
6. Por último, ejecute el siguiente comando para get todo pods para verificar el estado de su Pod.
En este caso, el ESTADO es Correr con cero (0) REINICIA, como se muestra a continuación, y su Pod está actualmente programado en un nodo. La API de Kubernetes aceptó su contenedor y la aplicación se ejecuta como se esperaba en su clúster de Kubernetes.
Examinar el estado CrashLoopBackOff de los pods
CrashLoopBackOff le indica que Kubernetes ha intentado reiniciar sus Pods repetidamente. El reinicio hace que el contenedor entre en un ciclo de bloqueo y reinicio, sin poder iniciarse. Pero hasta este punto, todavía no tienes idea de la razón principal detrás del error CrashLoopBackOff.
Debe resolver los comportamientos de bloqueo e iniciar su Pod como se esperaba. El comandos de condiciones le permite obtener información detallada sobre un Pod específico, profundizar en un Pod determinado y verificar sus eventos.
Para examinar el estado de CrashLoopBackOff de tus Pods:
Ejecute el siguiente comando para describe la información asociada con su pod.
Reemplazar pod_name con el que anotó en el paso tres de la sección “Solucionar configuraciones erróneas que causan errores CrashLoopBackOff”.
kubectl describe pod pod_name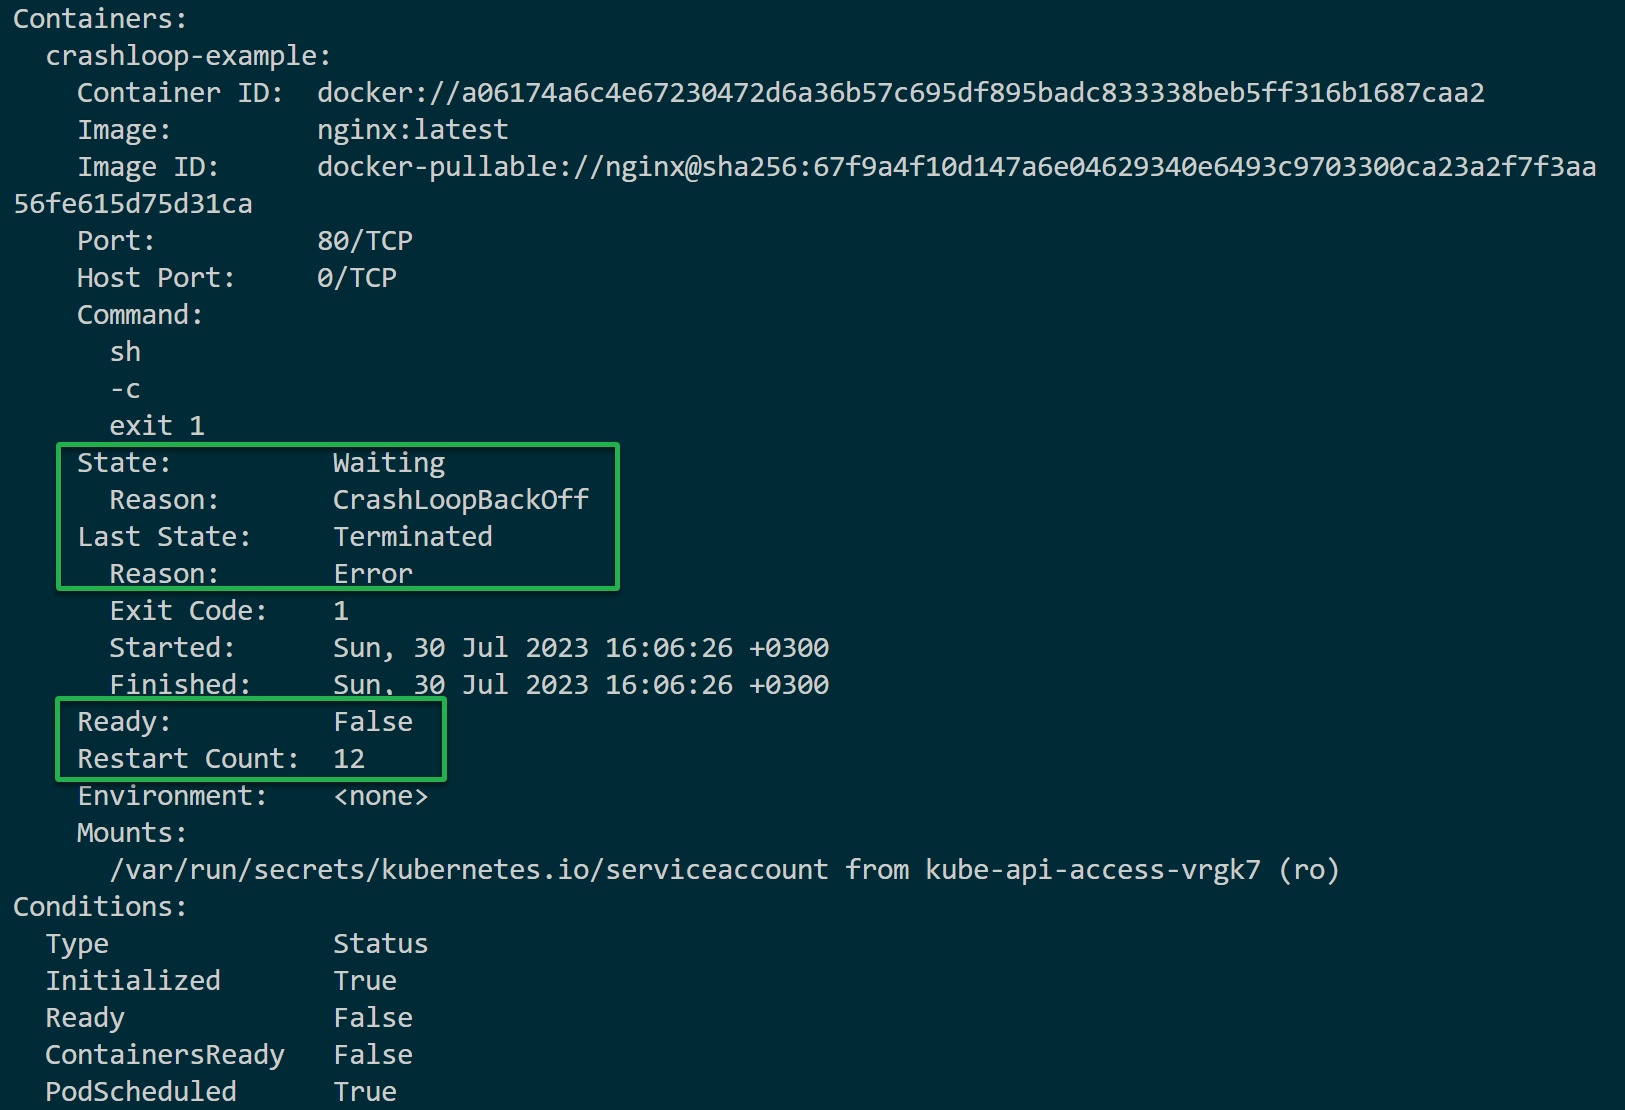
Bajo Eventosverás un Retroceder al reiniciar el contenedor fallido mensaje grabado por el kubelet. Este mensaje indica que el contenedor no responde y está en proceso de reiniciarse.

Cómo evitar que surjan errores CrashLoopBackOff
Acaba de solucionar el error CrashLoopBackOff, pero no recibir este error sería mucho mejor; como dice el refrán, “Más vale prevenir que curar”.
Pero, ¿cómo se puede evitar que surja este error? Primero, debe comprender las causas comunes por las que el contenedor no arranca correctamente y falla repetidamente.
1. Asegúrese de tener suficientes recursos para poner en marcha su clúster.
Suponiendo que su contenedor tiene las siguientes especificaciones en su clúster, intentó implementar un contenedor con recursos (memoria y CPU) más allá de lo especificado.
Dado que su clúster tiene recursos limitados, el contenedor es asesinado debido a limitaciones de recursos. El contenedor no se inicia en un bucle que fuerza su bloqueo, lo que genera un error CrashLoopBackOff.
containers:
  # Container name
  - name: container
    # Docker image
    image: your-image
    # Container resource limits
    resources:
      limits:
        # Maximum memory
        memory: "1Gi"
        # Maximum CPU usage
        cpu: "1000m"
2. A continuación, verifique si hay algún problema con su imagen.
Una imagen a la que le faltan paquetes, dependencias y variables de entorno incorrectas no se ejecutará en un clúster de Kubernetes.
Los errores de carga de configuración en Entrypoint y CMD se ejecutan en su propia imagen. El servidor que se ejecuta dentro del contenedor no podrá cargar el formato incorrecto del script y no podrá iniciarse en CrashLoopBackOff.
3. Corrija errores de configuración y tipográficos en sus Dockerfiles.
Supongamos que utiliza el Dockerfile a continuación, donde la ruta no existe en el contenedor o los permisos del sistema de archivos dentro del contenedor están configurados incorrectamente. El clúster que utiliza esta imagen no podrá acceder a dichos archivos en un bucle continuo de fallas.
FROM nginx
COPY nginx.conf /etc/ngin/nginx.conf
4. Verifique que no haya conflictos con el puerto del contenedor como en la configuración siguiente.
Al crear un clúster que ejecuta un contenedor que vincula un puerto existente, el contenedor actual no podrá iniciar sus pods.
El mismo escenario ocurre cuando se utilizan archivos y bases de datos bloqueados. Intentar acceder a recursos bloqueados por otro pod significa que no puede establecer una conexión con los recursos bloqueados.
  containers:
	# Frontend container binding to port 80
  - name: frontend
    image: your-image
    ports:
    - containerPort: 80
	# Backend container attempting to bind to the same port, 80
  - name: backend
    image: your-image
    ports:
    - containerPort: 80
5. Mantenga sus Pods actualizados simultáneamente en un StatefulSet a medida que realiza cambios sin alterar la disponibilidad de los Pods o servicios en ejecución. La actualización constante de los clústeres genera errores de requisitos que probablemente causarán fallas en CrashLoopBackOff.
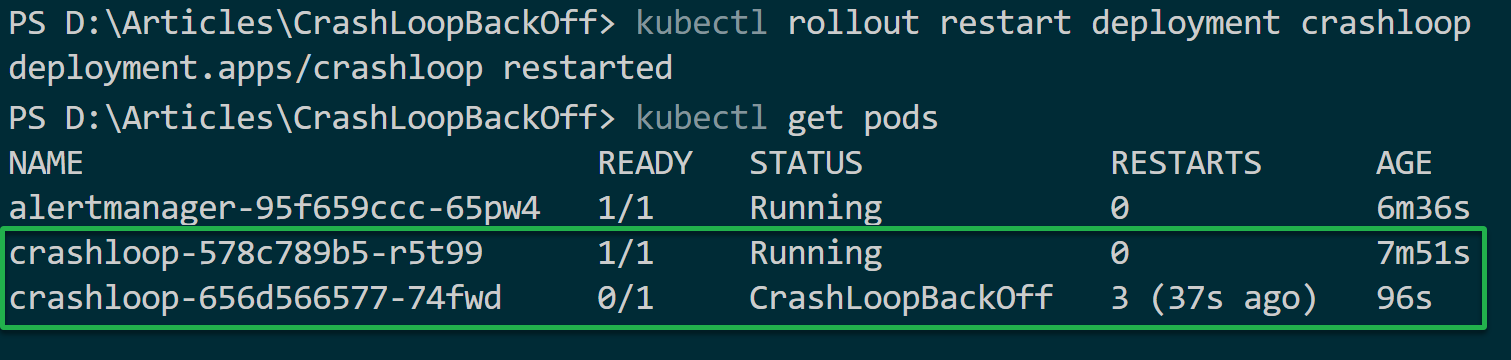
Ejecute los siguientes comandos para implementar actualizaciones, reinicie su deployment (deployment_name), y marque (get) todos corriendo pods.
# Roll out updates for Pods simultaneously
kubectl rollout restart deployment deployment_name
# Getting the list of all Pods
kubectl get pods
Si la nueva actualización provoca el error CrashLoopBackOff, los Pods más antiguos seguirán ejecutándose sin tiempo de inactividad mientras depura la causa raíz del interesante CrashLoopBackOff de los pods. En tales casos, es necesario monitorear la salud y el estado de sus pods y contenedores.
Conclusión
A lo largo de este tutorial, ha aprendido cómo solucionar un error CrashLoopBackOff y cómo ocurre en las implementaciones de Kubernetes. Ahora puede identificar con confianza la causa raíz del error, como limitaciones de recursos o problemas de configuración. Armado con este conocimiento, puede realizar los cambios correctos para mitigar el error CrashLoopBackOff.
Ahora, ¿por qué no ir más allá de abordar las fallas de contenedores y comenzar a monitorear su clúster de Kubernetes? ¡Recurra a Grafana y Prometheus para obtener ventaja a la hora de abordar errores y eventos ejecutados en cualquier clúster!

Leave a comment